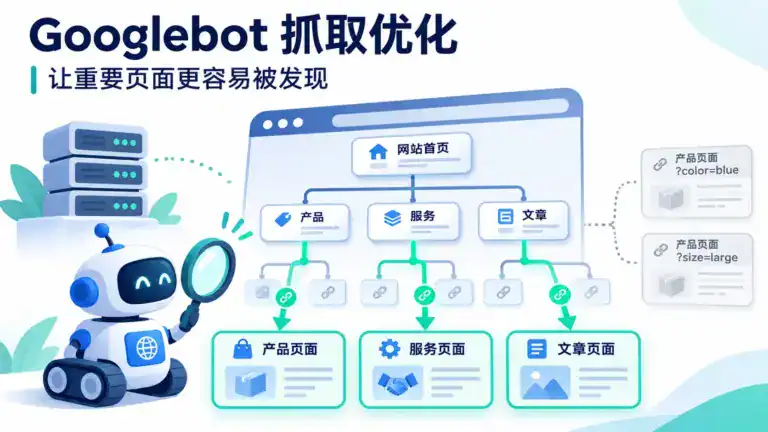
网站上线了新页面,Google 却迟迟没有抓取;博客持续更新,搜索结果里仍然看不到新内容;产品参数、筛选条件还生成了一大批重复网址——这类问题常被统称为“爬虫性能”问题。
优化重点不是让 Googlebot 尽可能多地访问网站,而是让它能稳定访问网站,并更容易发现值得抓取的页面。Google 官方指出,抓取预算主要适用于拥有大量、频繁更新页面的网站;如果网站规模不大、重要页面通常能及时被抓取,就不必把“抓取预算”当成首要任务。
下面结合 Google 官方资料和相关 SEO 指南,整理一套适用于企业网站、电商网站和内容网站的谷歌搜索引擎爬虫性能优化建议。
一、先分清抓取、收录和排名
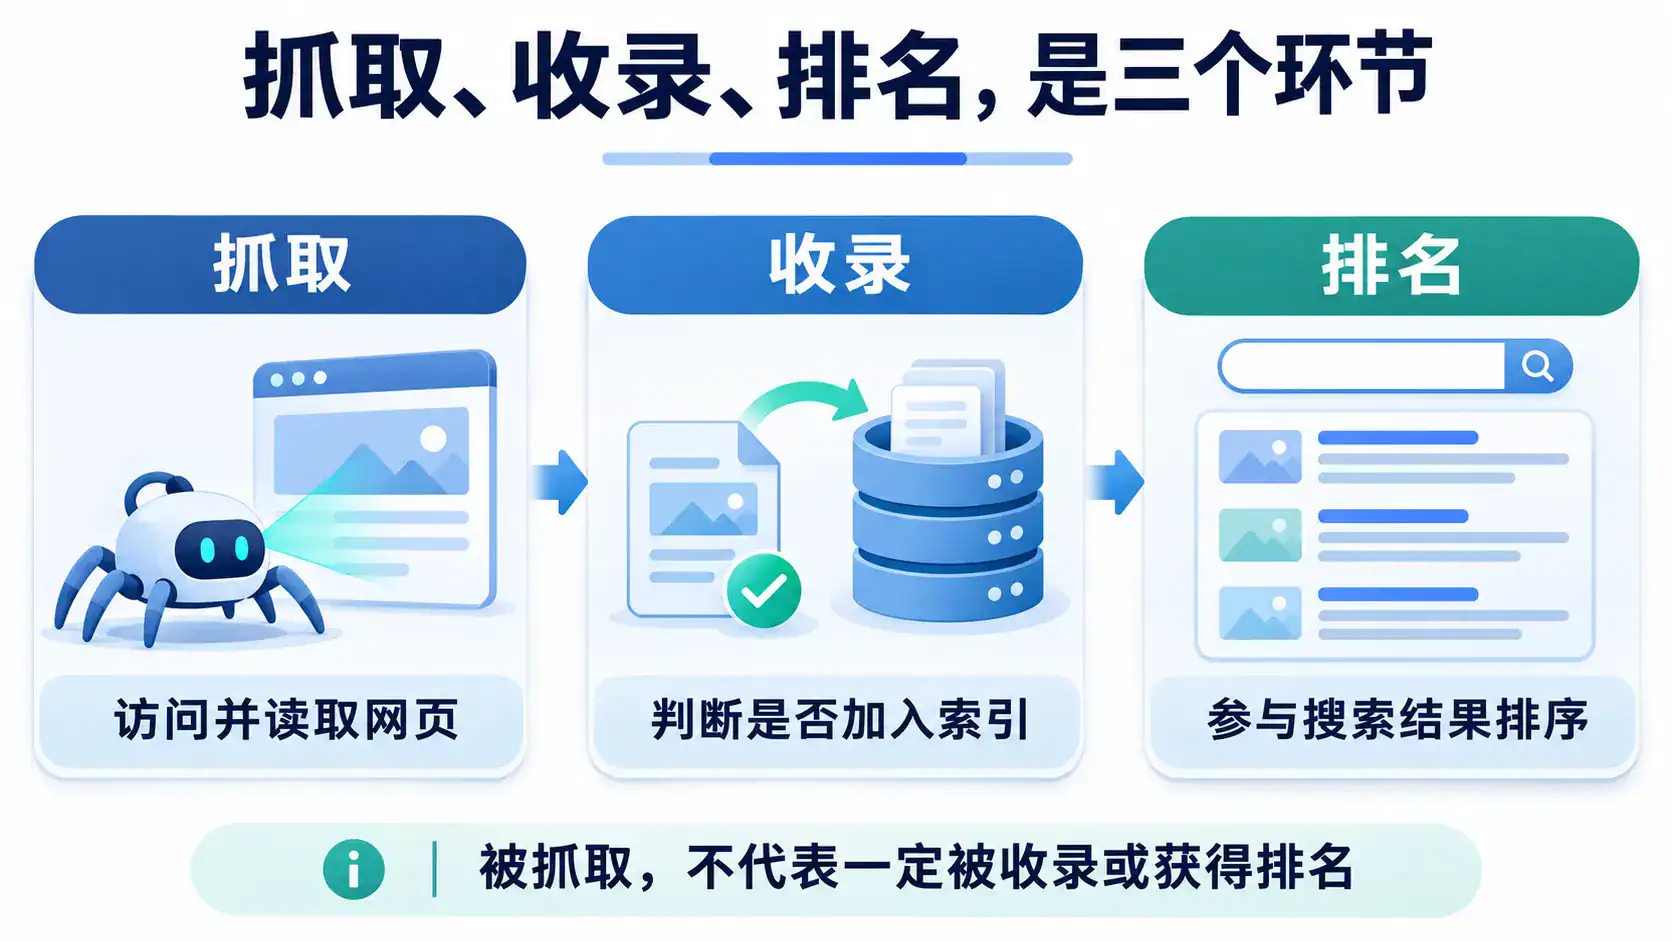
这三个环节经常被混为一谈:
- 抓取:Googlebot 访问网页并读取内容。
- 收录:Google 判断网页是否适合加入搜索索引。
- 排名:网页参与搜索结果排序。
页面没收录,不一定是爬虫没访问;被抓取了,也不代表一定会被收录或获得排名。Google 对网页的处理还包括渲染和索引等步骤,页面内容、规范网址、状态码和索引设置都会影响后续判断。
因此,优化前先确认问题出现在哪一步。可以在 Google Search Console 检查网址检查结果、网页索引报告和抓取统计;大规模网站还可结合服务器日志,查看 Googlebot 实际访问了哪些网址、返回了什么状态码。
二、不要把抓取预算问题套在所有网站上
抓取预算通常与网站规模、更新频率、服务器承载能力以及 Google 对网页的抓取需求有关。对只有几十或几百个主要页面的网站,优先排查页面能否访问、内部链接是否通畅、内容是否有价值,往往比研究抓取预算更实际。
如果网站有成千上万甚至更多网址,尤其是电商筛选页、搜索结果页、论坛分页或频繁变化的内容页,就更值得检查 Googlebot 是否把时间花在了低价值网址上。Google 的抓取预算指南特别面向大型、经常更新的网站。
三、清理重复和低价值网址,减少无效抓取
电商网站的筛选和排序功能很容易产生大量网址。例如,同一类商品通过颜色、价格、尺寸等条件组合后,可能形成许多内容相似的页面。分页、站内搜索结果、追踪参数和会话参数也可能带来类似问题。
建议逐项盘点:
- 是否有大量参数网址指向内容相同或高度相似的页面;
- 站内搜索结果、排序页是否有必要被 Google 抓取;
- 是否存在无限分页、日历或筛选组合;
- 旧版页面、重复页面是否仍被内链或站点地图引用;
- 规范网址(canonical)是否指向正确的主要版本。
不要只靠屏蔽网址来处理重复页面。应先确定哪些页面需要被搜索引擎发现、哪些只是功能性页面,再选择适合的技术方案。robots.txt 能限制抓取,但不是隐藏网址或保证其不出现在搜索结果中的工具;被屏蔽的网址仍可能因外部链接等原因被 Google 发现。
四、谨慎设置 robots.txt,别误挡重要页面
检查网站根目录下的 robots.txt,确认规则没有误挡重要页面或 Googlebot 需要读取的资源。常见风险包括:
- 整站或重要目录被意外禁止抓取;
- CSS、JavaScript 等必要资源被屏蔽,导致 Google 无法正确渲染页面;
- 更新网站结构后,旧规则仍然拦截新页面;
- robots.txt 本身无法正常访问。
robots.txt 控制的是爬虫能否抓取网址,不等同于 noindex。如果目的是防止页面出现在 Google 搜索结果中,应根据具体情况使用 noindex、访问权限控制或删除页面等方法,而不是单纯封锁抓取。
五、改善服务器稳定性和响应速度
Googlebot 会根据网站的响应情况调整抓取。如果服务器响应变慢或频繁返回服务器错误,Googlebot 可能降低抓取频率,以避免给网站带来过大负担。
可以优先检查:
- 是否频繁出现 5xx 错误、超时或连接失败;
- DNS 是否稳定,服务器是否经常不可用;
- 高峰时段数据库查询或页面生成是否过慢;
- 缓存、CDN 和服务器资源配置是否合理;
- 是否存在跳转循环或过长的重定向链。
Search Console 的抓取统计报告可以查看抓取请求、响应状态和主机状态等信息。若发现抓取量突然下降,不要立刻把原因归结为“预算不足”,先核对服务器响应速度、错误率和 robots.txt 状态。
六、修复错误网址和低效重定向
网站改版、删除内容或调整网址后,旧链接可能继续出现在站内链接、站点地图或外部网站中。Googlebot 每次访问这些链接,都可能遇到 404、重定向或服务器错误。
建议定期处理:
- 修复重要页面上的失效内链;
- 将确实迁移的页面做一对一重定向;
- 清理重定向链和循环跳转;
- 删除站点地图中的失效网址;
- 对已经不存在且没有替代页面的网址,返回正确的 404 或 410 状态。
对于确实移动到新网址的内容,明确的重定向比让爬虫经过多次跳转更清晰。Google 官方也建议使用有意义的 HTTP 状态码告诉 Googlebot 页面是否存在、是否需要跳转。
七、让重要页面更容易从网站结构中被发现
爬虫需要通过网址和链接发现页面。重要页面如果没有内部链接入口,即使存在于网站后台,也可能很难被顺利发现。
可以从几个方面改善:
- 在导航、分类页或相关内容中链接到核心产品页和服务页;
- 让重要页面不必经过过多层级才能到达;
- 检查孤立页面,补充合理的内部链接;
- 使用可抓取的 HTML 链接,让链接地址位于
<a>元素的href属性中; - 避免只依赖按钮点击或复杂脚本来加载关键链接。
Googlebot 会解析网页中的链接并将其加入抓取队列;对于 JavaScript 网站,Google 也会在处理和渲染页面后继续解析链接,但关键内容如果能在初始 HTML 中清楚呈现,通常更容易被访问和理解。
八、维护准确的 XML 站点地图
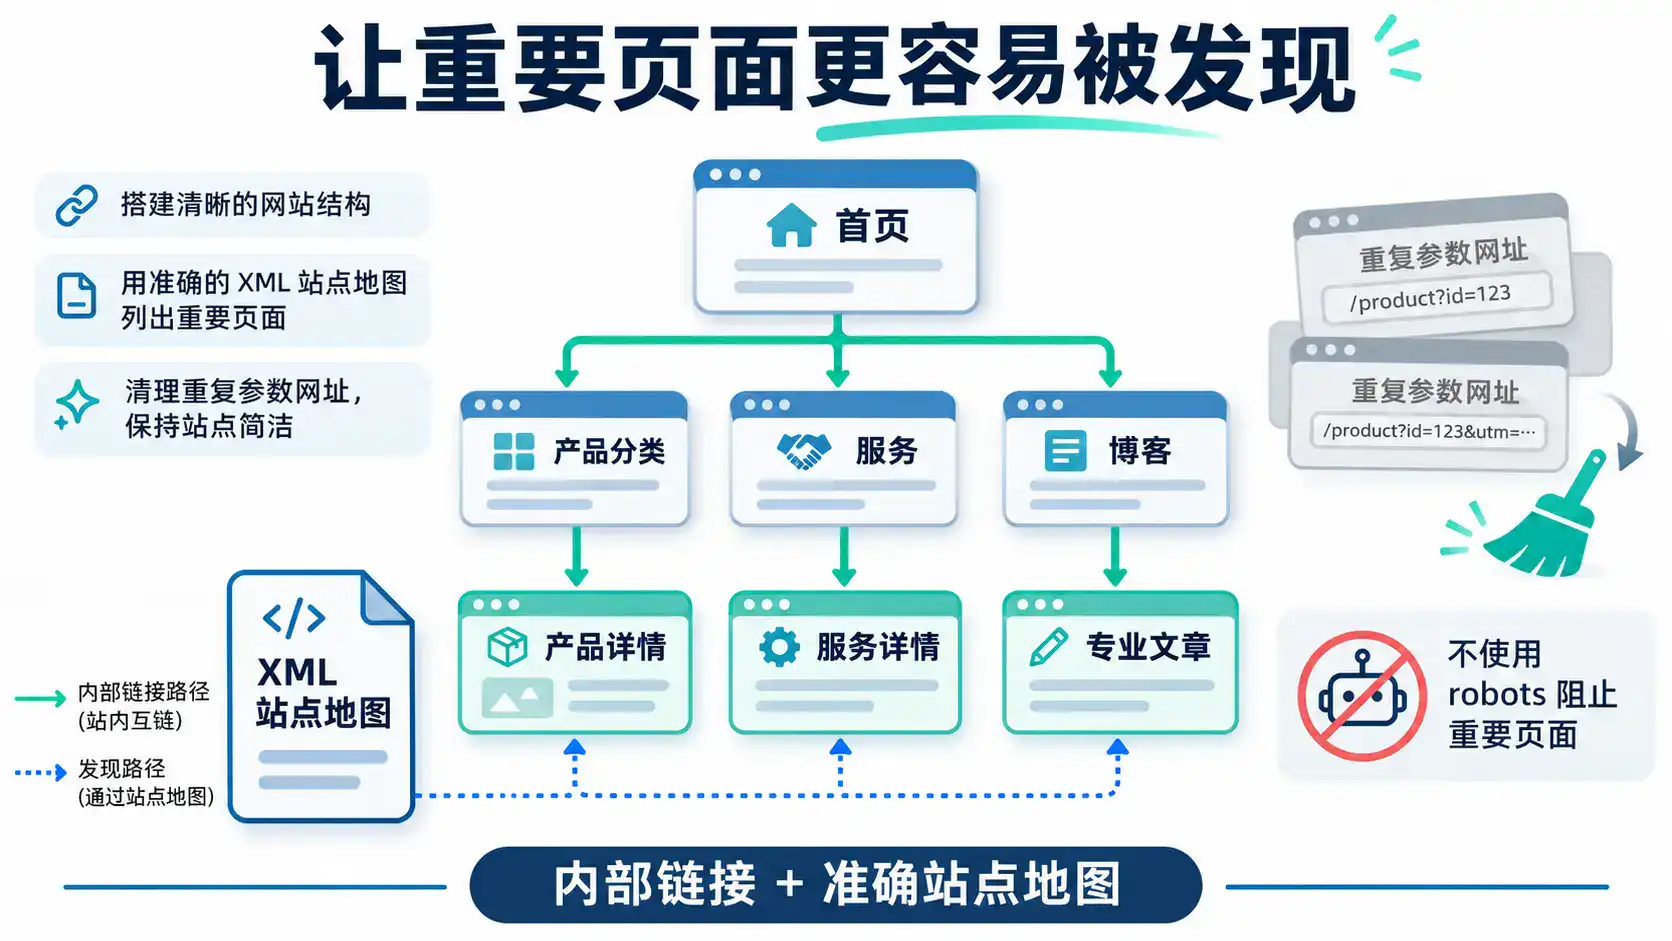
XML 站点地图可以帮助 Google 发现网站上的重要网址,但提交站点地图并不保证页面一定被抓取或收录。它更像是一份网址提示清单,而不是收录承诺。
站点地图应重点关注:
- 只保留希望出现在搜索结果中的规范网址;
- 移除返回错误状态或已经重定向的网址;
- 页面更新后及时维护相关信息;
- 检查站点地图是否能正常访问,并在 Search Console 中查看处理情况。
同时,站点地图不能代替良好的内部链接。重要页面最好既出现在站点地图中,也能从网站结构中被正常访问。
九、JavaScript 网站要检查渲染后的内容
如果网页主要依赖 JavaScript 加载正文、导航或产品信息,搜索引擎处理页面时可能需要额外的渲染步骤。Googlebot 会把部分页面加入渲染队列,但渲染并不一定立刻发生;Google 也建议尽可能让网站对用户和爬虫都保持快速、稳定。
建议使用 Search Console 的网址检查工具查看 Google 抓取后的页面,并重点确认:
- 正文是否完整显示;
- 主要链接是否能被发现;
- 页面标题和规范网址是否正确;
- robots meta 标签是否被意外设置为
noindex; - 重要资源是否被 robots.txt 屏蔽;
- 不存在的页面是否返回真实的 404,而不是展示错误文案却仍返回 200。
对于内容型网站和服务页面,服务端渲染或预渲染也可以作为提升加载体验、降低对客户端脚本依赖的方案之一。
十、提高内容质量,明确哪些页面值得反复抓取
爬虫优化不只是技术配置。对网站来说,内容是否有用、页面是否保持更新、品牌和主题信息是否清楚,也会影响搜索引擎对页面的判断。
如果网站有很多内容相似、信息过时或几乎没有独立价值的页面,单纯增加抓取请求并不能解决问题。更有效的做法通常是:
- 合并重复主题,保留更完整、更有用的页面;
- 更新过时的信息和失效链接;
- 为重要产品、服务和案例页面补充具体内容;
- 删除或处理长期无价值的薄内容;
- 通过内部链接强调哪些页面是网站的核心内容。
目标不是让 Googlebot 访问每一个可能生成的网址,而是让网站更容易呈现清晰、有价值、值得被搜索的页面。
十一、建立固定的抓取问题排查流程
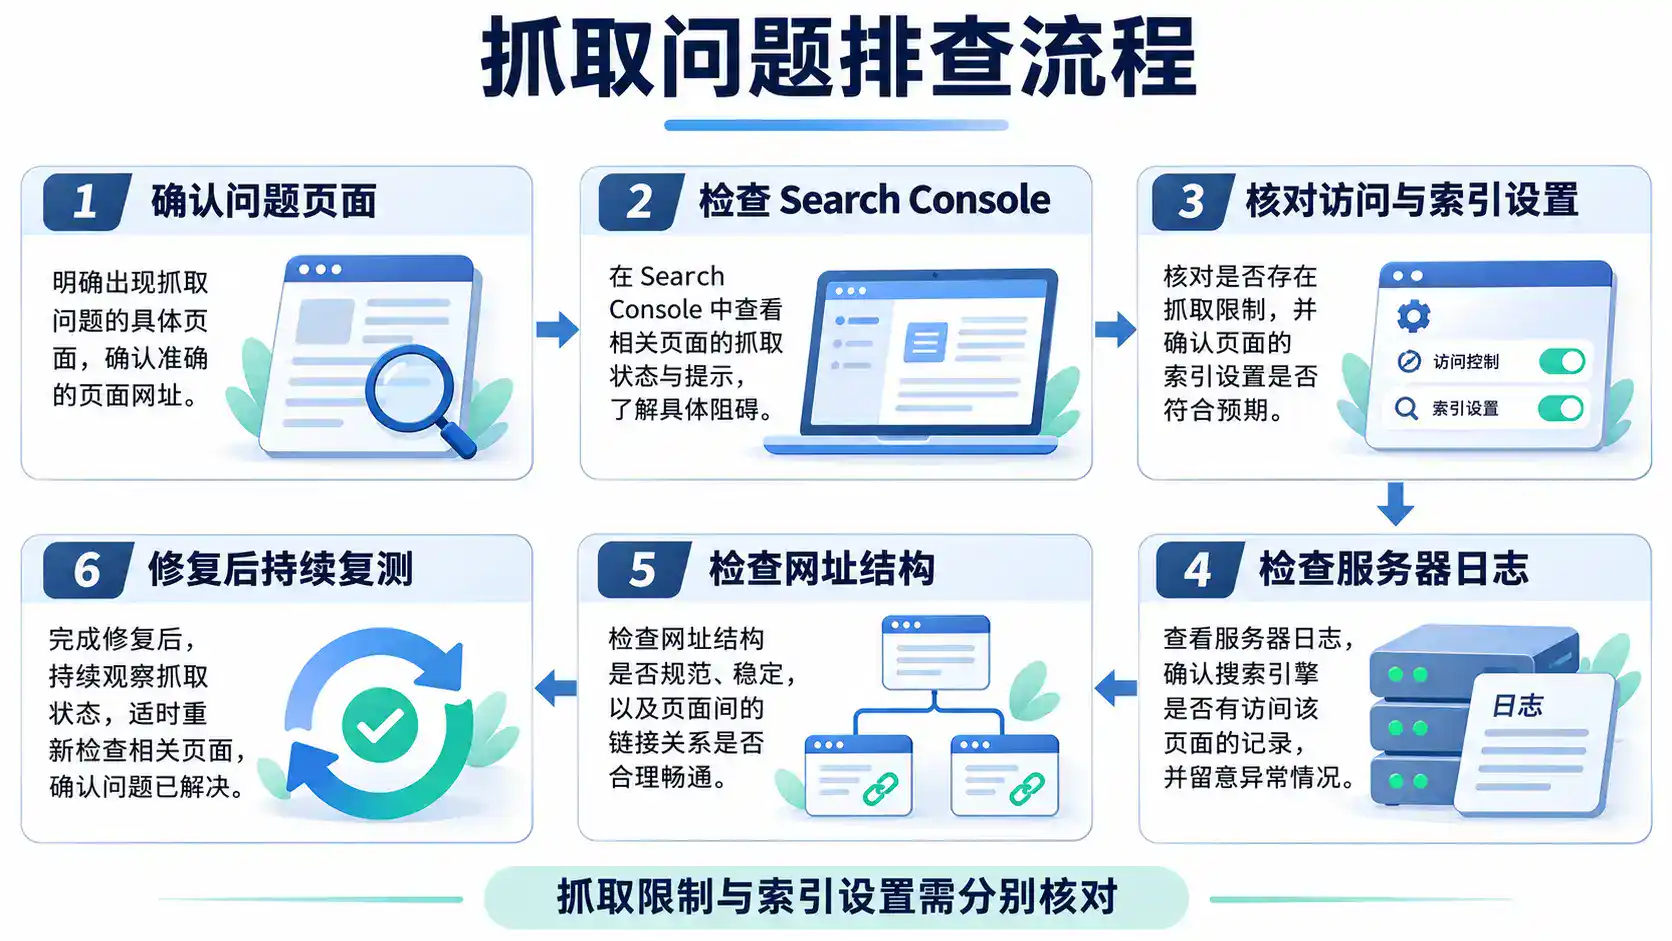
爬虫性能需要持续观察,特别是网站改版、上线新分类、调整 URL 规则或迁移服务器之后。可以按下面的顺序排查:
- 确认问题页面:是少数新页面,还是大量重要页面都未被抓取?
- 检查 Search Console:查看网址检查、网页索引和抓取统计报告。
- 核对抓取限制:确认 robots.txt、noindex 和访问权限没有误配置。
- 检查服务器日志:了解 Googlebot 请求的网址、频率和响应状态。
- 检查网址结构:寻找参数膨胀、重复页面、重定向链和孤立页面。
- 修复后复测:重新抓取重要页面,并持续观察报告变化。
如果只是少数页面尚未收录,可以先检查页面质量、内部链接和索引状态;如果大量页面抓取异常,再重点调查服务器、网址管理和爬虫访问限制。
总结:把爬虫资源留给真正重要的页面
谷歌搜索引擎爬虫性能优化的核心,不是让 Googlebot“爬得越多越好”,而是消除抓取障碍、减少无效网址,并让网站的重要内容更容易被发现。对大型或频繁更新的网站,这能帮助提高抓取效率;对中小型网站,修复技术错误、做好内部链接和提升内容质量通常更值得优先投入。
如果你不确定网站是否存在重要页面抓取不到、参数网址过多、服务器错误或 JavaScript 渲染异常等问题,我么可以结合 SEO 与 GEO 服务,帮你检查网站的技术基础、内容结构和搜索表现,并提供一次免费的 SEO 评估。欢迎访问 https://www.dianjin-inc.com,了解网站目前的优化空间,以及下一步如何让重要内容更容易被搜索引擎和 AI 搜索发现。